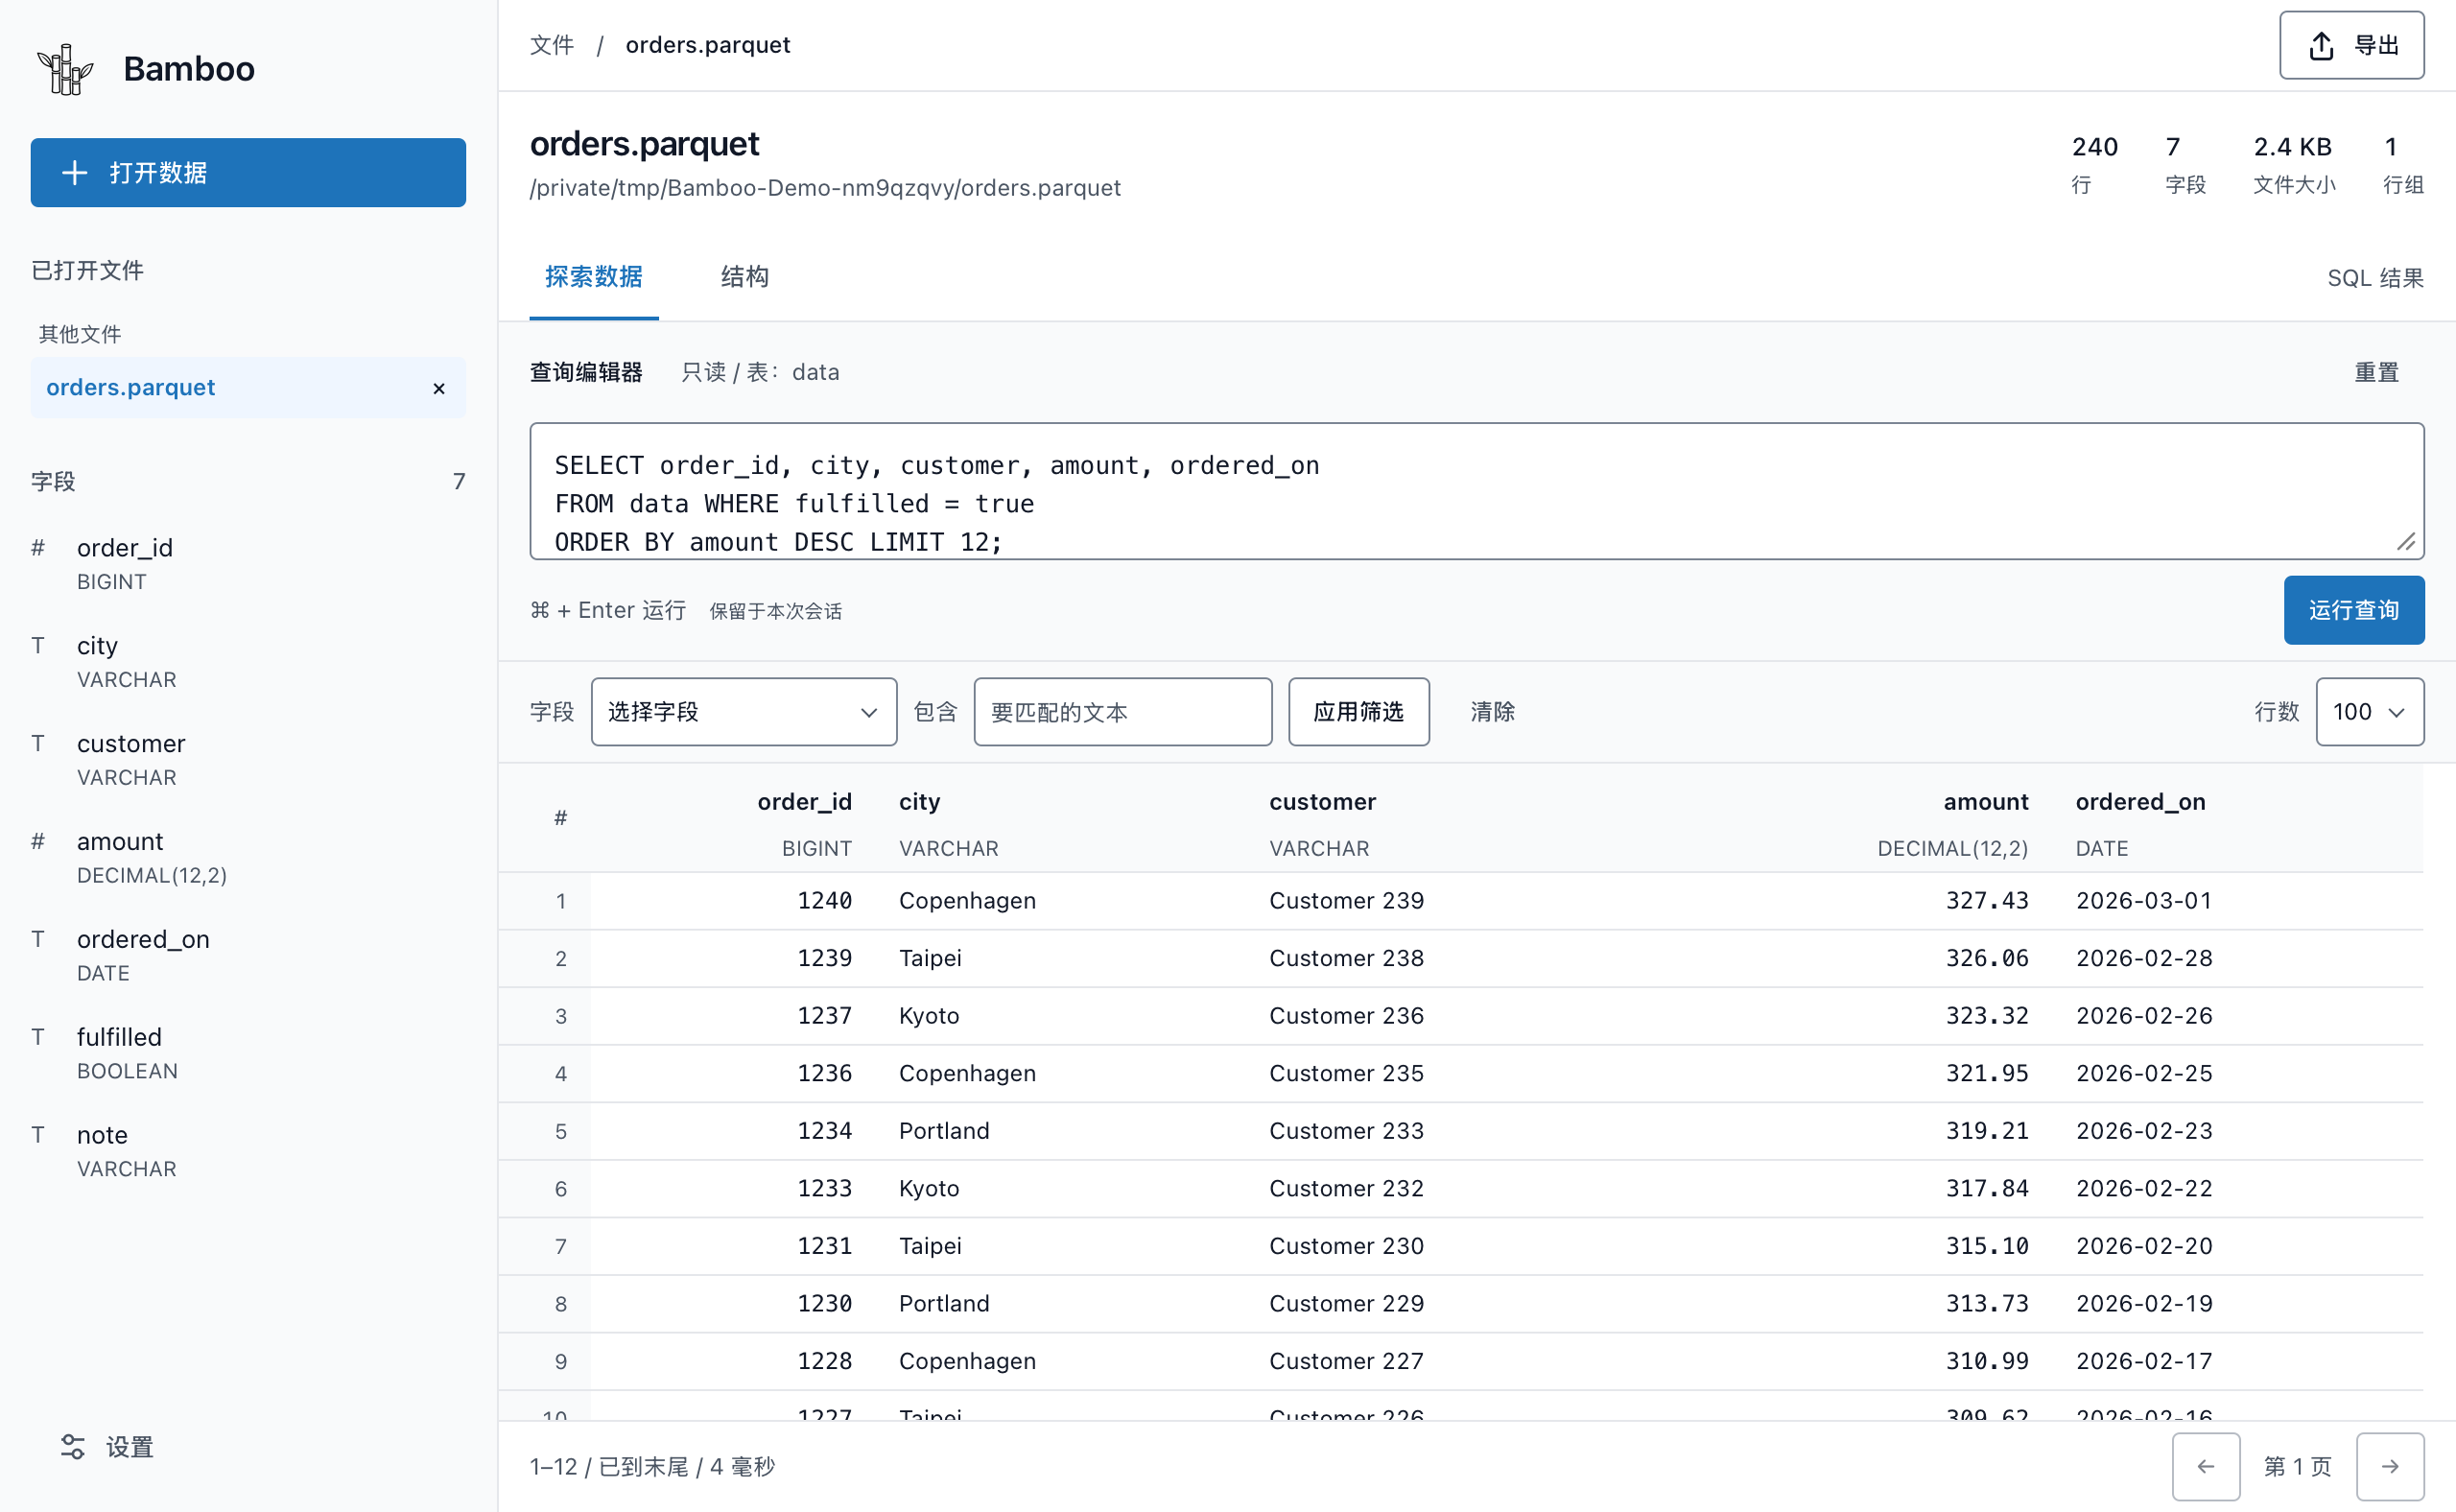
SELECT city, amount
FROM data
WHERE fulfilled = true
ORDER BY amount DESC
LIMIT 12;
会写 SQL,就会用。
预览、筛选和排序,用 SQL 跨文件关联与聚合。导出可选当前页或完整结果,支持 CSV、TSV、JSON 和 JSONL,并可取消。
主动查看完整查询的列统计,生成并导出 COUNT/SUM/AVG/MIN/MAX 透视;不把当前页当作全量。
A LITTLE BAMBOO. A LOT OF DATA.
打开文件,看见数据,写下你的第一条 SQL。
从本地到云端,把探索数据的时间,还给你。
文件在哪里,工作台就在哪里。
少一点准备,多一点发现
不必先建库、写脚本。打开 Parquet 或本地 CSV/TSV,就能开始探索。
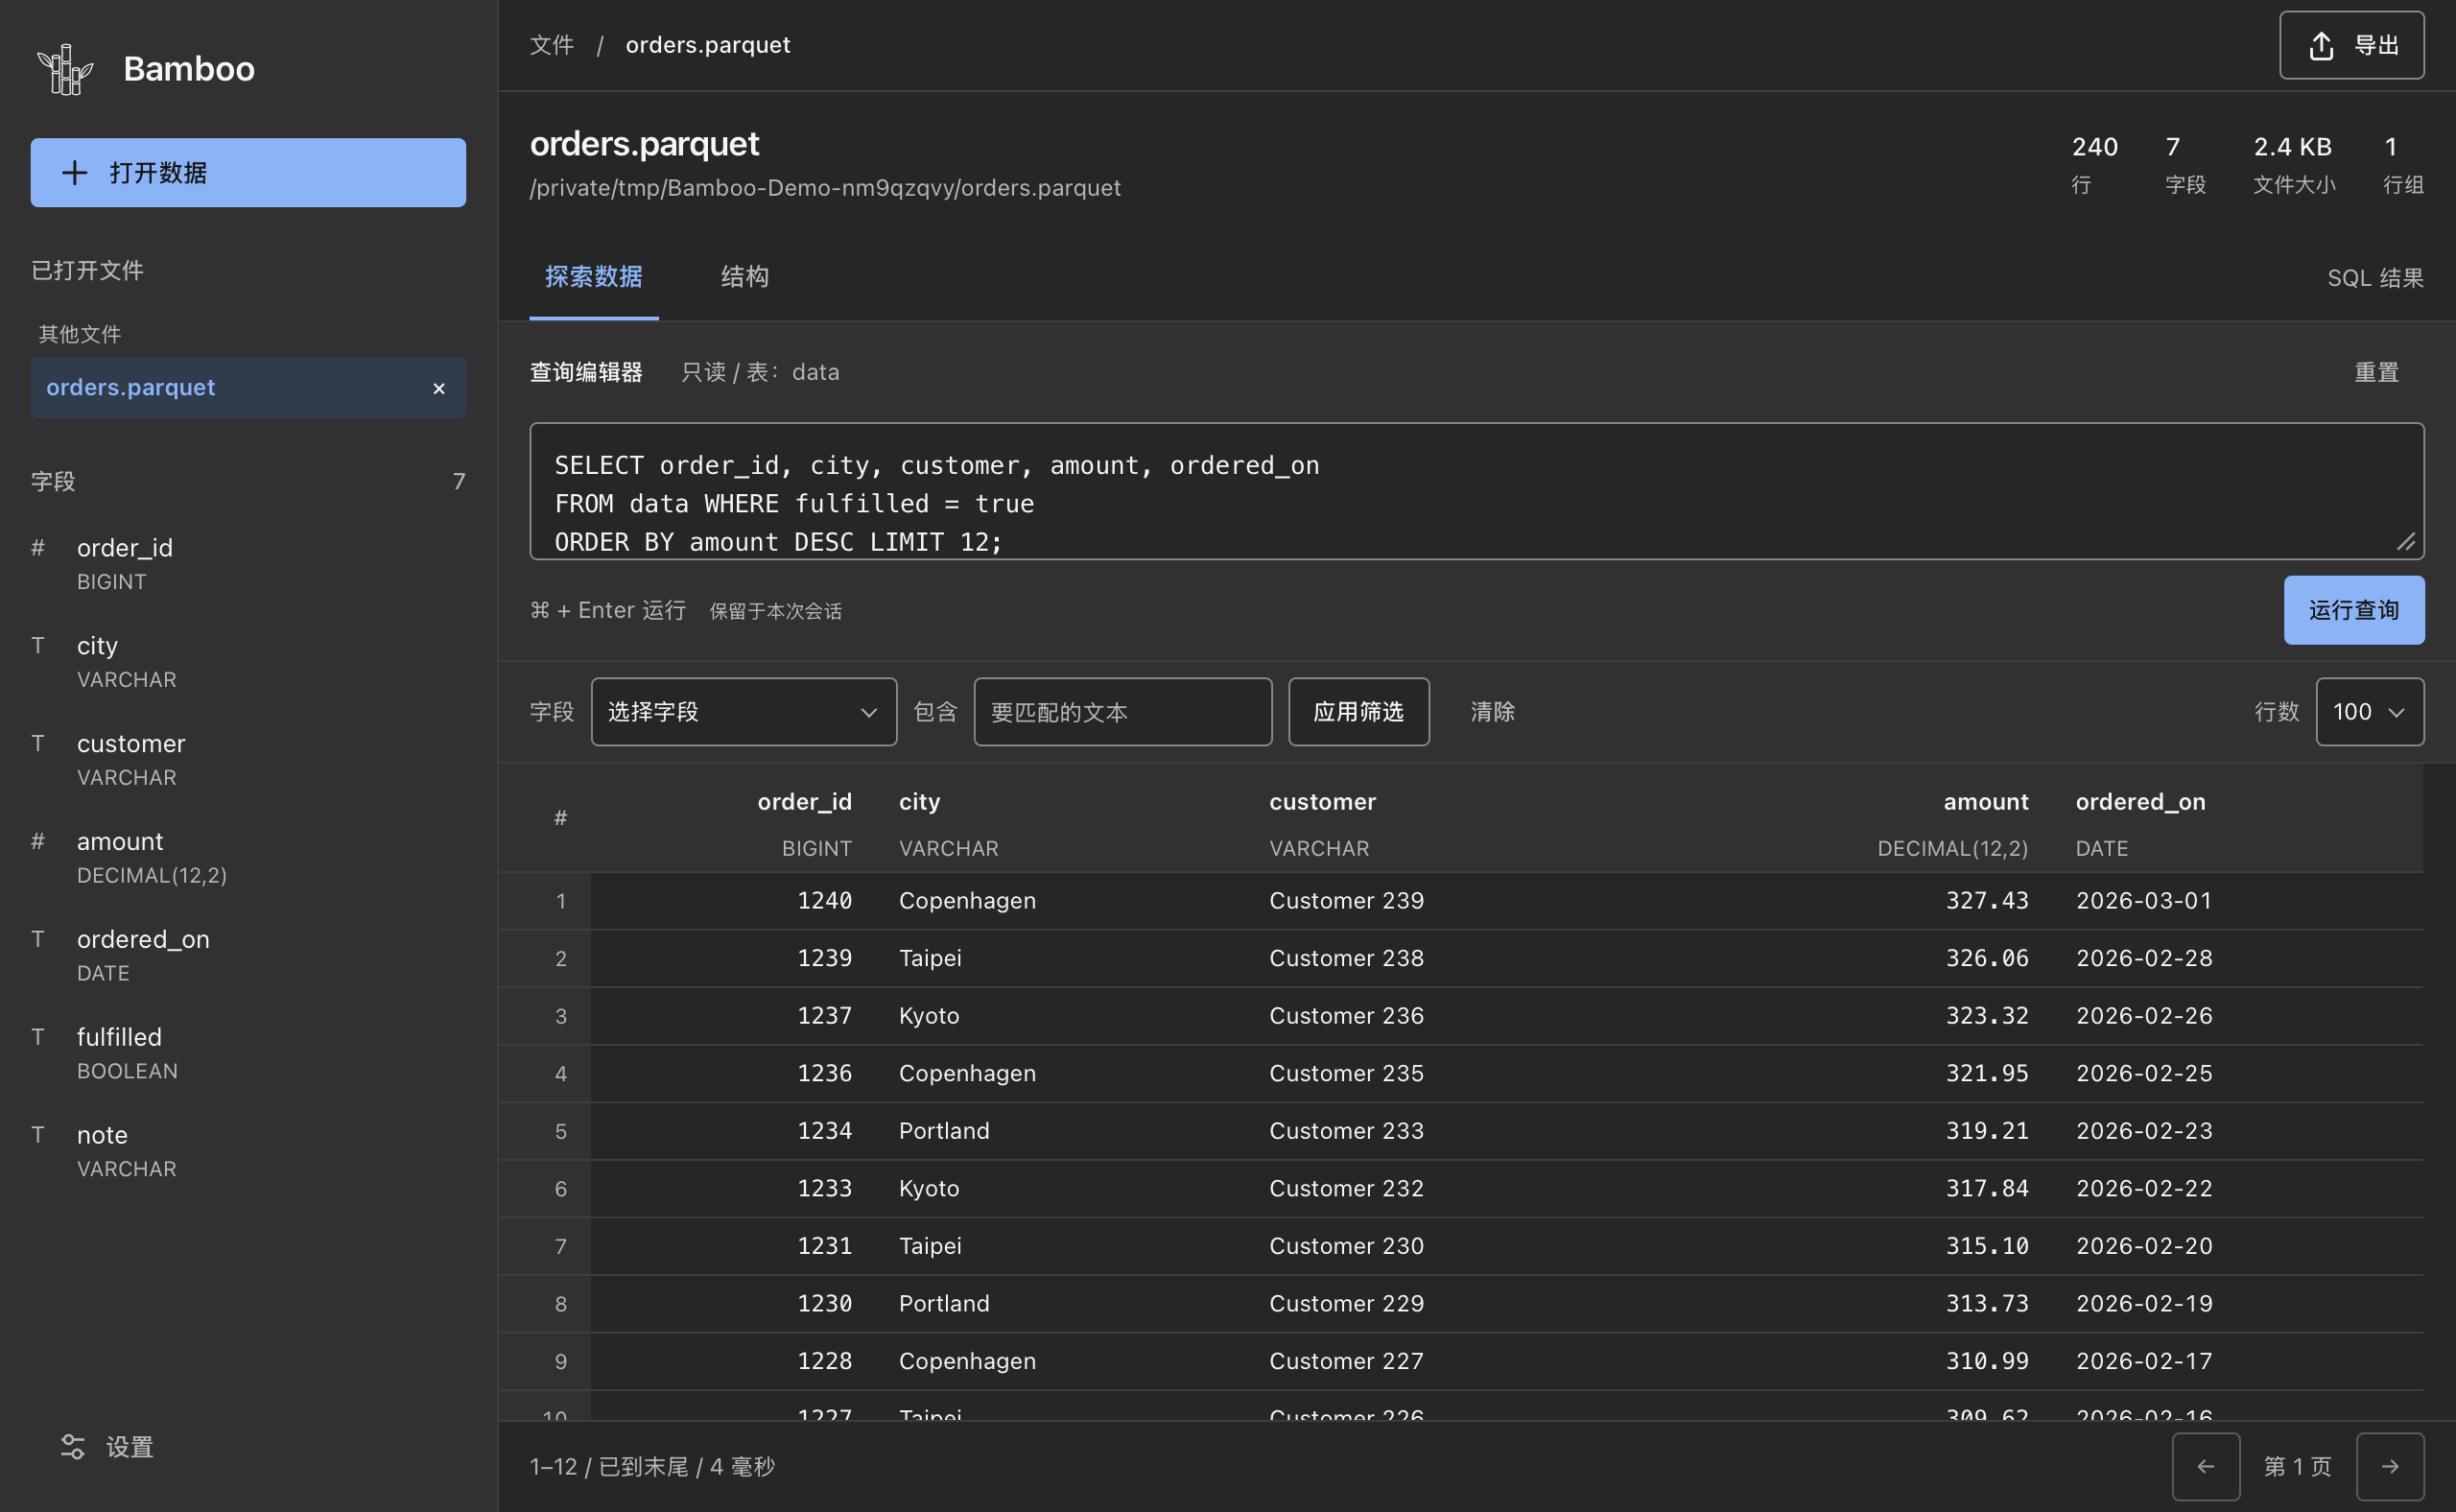
SELECT city, amount
FROM data
WHERE fulfilled = true
ORDER BY amount DESC
LIMIT 12;预览、筛选和排序,用 SQL 跨文件关联与聚合。导出可选当前页或完整结果,支持 CSV、TSV、JSON 和 JSONL,并可取消。
主动查看完整查询的列统计,生成并导出 COUNT/SUM/AVG/MIN/MAX 透视;不把当前页当作全量。
打开电脑上的文件或整个文件夹,也能直接连接 Amazon S3 和 Cloudflare R2。多个工作区,在同一个窗口里切换。
在设置中调整 75%–200% 应用缩放与数据字号,重启后继续使用。
| 文件大小 | 本地耗时 | S3 耗时 | R2 耗时 |
|---|---|---|---|
| 128MB | 37.0 ms | 1.50 s | 1.57 s |
| 512MB | 36.2 ms | 1.38 s | 1.76 s |
| 1GB | 38.0 ms | 1.16 s | 1.57 s |
| 2GB | 39.8 ms | 1.34 s | 1.63 s |
Parquet 按需读取需要的数据,不用先把整个文件塞进内存。GB 级 Parquet 也能快速看见首屏,内存与临时磁盘预算由你掌握。以下性能数据仅适用于 Parquet。
从下载,到第一条查询
选择平台,查看系统要求与首次安装步骤。
点击免费下载 macOS 版,获取 .dmg 安装文件。M1、M2、M3、M4 等 Apple 芯片 Mac 均属于 Apple Silicon;目前不提供 Intel 版。
双击下载的 DMG,把 Bamboo 拖到 Applications(应用程序)。复制完成后,推出安装磁盘,从「应用程序」打开 Bamboo。
将 .parquet / .csv / .tsv 文件拖进欢迎页的大框,或点击 Open data(打开数据)。也可以选择文件夹,或连接 S3 / R2 工作区。
当前版本尚未经过 Apple 公证,首次打开时可能提示“无法验证开发者”或“Apple 无法检查其是否包含恶意软件”。确认你从本页链接的 GitHub Release 下载后,可以按以下步骤允许打开。
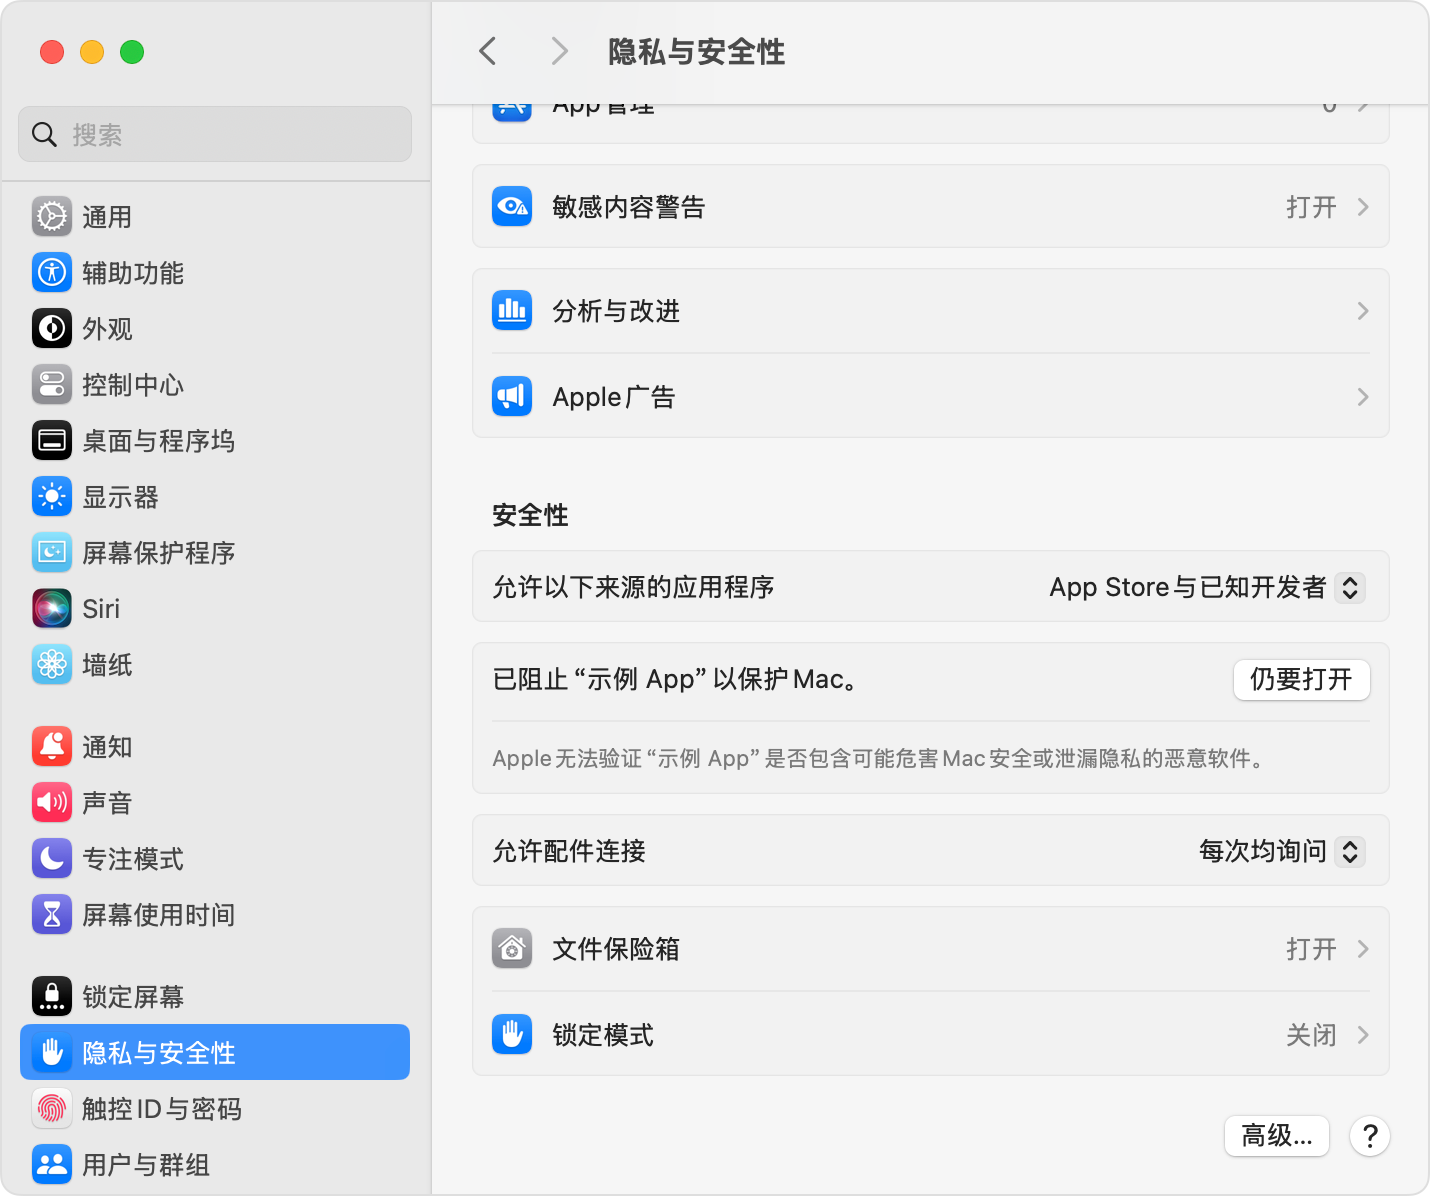
如果没有出现“仍要打开”,先确认刚刚尝试过打开 Bamboo;受单位管理的 Mac 可能需要管理员协助。若系统提示“会损坏电脑”或文件已损坏,请停止打开,重新从 Release 下载,仍有问题可到 GitHub Issues 反馈。查看 Apple 官方说明 ↗
Windows 10/11 x64,需要 Microsoft Edge WebView2 Evergreen x64 Runtime;不提供 ARM64 或 32 位安装包。
从 Microsoft 获取 WebView2 ↗运行 setup.exe 安装包,为当前用户安装;或完整解压便携 ZIP,再打开 Bamboo/bamboo.exe。请保留同目录的 extensions 和 licenses 文件夹。
Windows 安装包尚未签名,可能显示 SmartScreen 警告。请先核对下载来源和版本说明;不要关闭系统保护。受管理的电脑请联系管理员。
云访问凭据保存在 Windows 凭据管理器中。检查更新会打开正式版本页面,下载和安装由你手动完成。卸载前可先在 Bamboo 中删除不再需要的云连接。
已在 Ubuntu 22.04 x64 验证;兼容 Debian 的桌面系统需要 GTK 3、WebKitGTK 4.1 和 libsecret。其他发行版未验证,不提供 ARM64 安装包。
在下载目录使用以下命令安装 DEB,将文件名替换为实际下载的版本:
sudo apt install ./Bamboo-<version>-linux-x64.deb
也可完整解压 tar.gz 并运行 Bamboo/bamboo。便携包不会安装系统依赖,请保留 extensions 和 licenses 文件夹。
本地文件可直接打开。云连接需要正在运行的用户 D-Bus 会话和已解锁的 Secret Service(例如 GNOME Keyring);凭据库不可用时会提示错误,不会改用明文保存。
检查更新会打开正式版本页面,下载和安装由你手动完成。卸载会保留设置和凭据;如不再需要,请先在 Bamboo 中删除云连接。
你可能还想知道
Bamboo 支持 macOS Apple Silicon、Windows x64 和 Linux x64。正式下载以页面底部下载区和 GitHub Releases 为准;预览构建不等于正式发布。不提供 Intel Mac 或 Windows/Linux ARM64 安装包。macOS 要求 12 及以上,可在 → 关于本机查看芯片与系统版本。本地支持 Parquet、CSV 和 TSV,S3/R2 支持 Parquet。可导出当前页、完整查询或透视快照,格式包括 CSV、TSV、JSON 和 JSONL。
Bamboo 没有后端服务器,不会接收或存储你的文件、SQL、查询结果或云端凭据。所有查询和数据处理都在你的电脑本地完成,应用配置也保存在本机。连接 S3 或 R2 时,由你的电脑直接按需读取你自己的云端存储;访问凭据保存在本机的系统凭据库中:macOS 钥匙串、Windows 凭据管理器或 Linux Secret Service。
对当前文件,输入
SELECT * FROM data LIMIT 100;,点击 Run query(运行查询)即可。文件夹工作区支持跨文件查询,例如
SELECT * FROM workspace."orders.parquet" LIMIT 100;。你也可以直接预览、筛选和排序,不必先写 SQL。
不会。Bamboo 以只读方式打开和查询 Parquet 文件,预览、筛选、排序和 SQL 查询都不会修改原文件。导出结果会创建新文件。
macOS 版 Bamboo 可以在后台检查更新,有新版本时会在左下角提示。点击更新提示,按提示确认安装并重新启动即可;你也可以在「设置 → 通用」中手动检查更新。安装和重启都需要你主动确认,不会在使用过程中自动升级。更新从本项目的 GitHub Releases 获取。Windows/Linux 的「检查更新」会打开版本页面,由你手动下载和安装。
Bamboo 免费开源,采用 MIT 许可证。发现 Bug 可以到 GitHub Issues;使用问题、想法和建议欢迎到 GitHub Discussions 讨论。反馈时请注明应用版本、操作系统版本和重现步骤,并隐去密钥、私人路径和业务数据。
一起,让它更好用
到 GitHub 留下你的反馈。
一次讨论,也可能成为 Bamboo 的下一个小进步。
下一份数据,已经准备好了
免费开源。为你的数据,也为你的好奇心。